لماذا ينجح تحويل النصوص إلى استعلامات SQL في العروض التجريبية ويفشل في قواعد بيانات المؤسسات
اطرح سؤالاً على أداة الذكاء الاصطناعي حول أفضل 10 عملاء تحقيقاً للإيرادات في قاعدة بيانات تجريبية مكونة من 8 جداول وستحصل على استعلام سليم، لكن عند تطبيقه على نظام تخطيط موارد المؤسسات (ERP) بآلاف الجداول سيفشل تماماً. اكتشف أسباب ذلك وكيف يعالج استرجاع المخططات، والطبقة الدلالية، والتحقق المسبق هذه الفجوة.
اطرح على إحدى أدوات الذكاء الاصطناعي سؤالاً مثل: "من هم أفضل 10 عملاء لدينا من حيث الإيرادات في الربع الأخير؟" أمام قاعدة بيانات تجريبية تحتوي على ثمانية جداول، وستقوم الأداة في معظم الأحيان بتوليد استعلام SQL معقول ومناسب.
الآن، اطرح السؤال نفسه على نظام تخطيط موارد المؤسسات (ERP) قيد التشغيل الفعلي يحتوي على آلاف الجداول، ومئات الآلاف من الأعمدة، وسنوات من قواعد ومنطق الأعمال المتراكمة.
ستكون النتيجة مختلفة تماماً.
قد يختار النموذج جداول غير صحيحة، أو ينشئ عمليات ربط (Joins) خاطئة، أو يسيء فهم مفهوم الإيرادات، أو يقدم نتائج تبدو دقيقة ظاهرياً ولكنها لا تعكس الواقع الفعلي للمؤسسة.
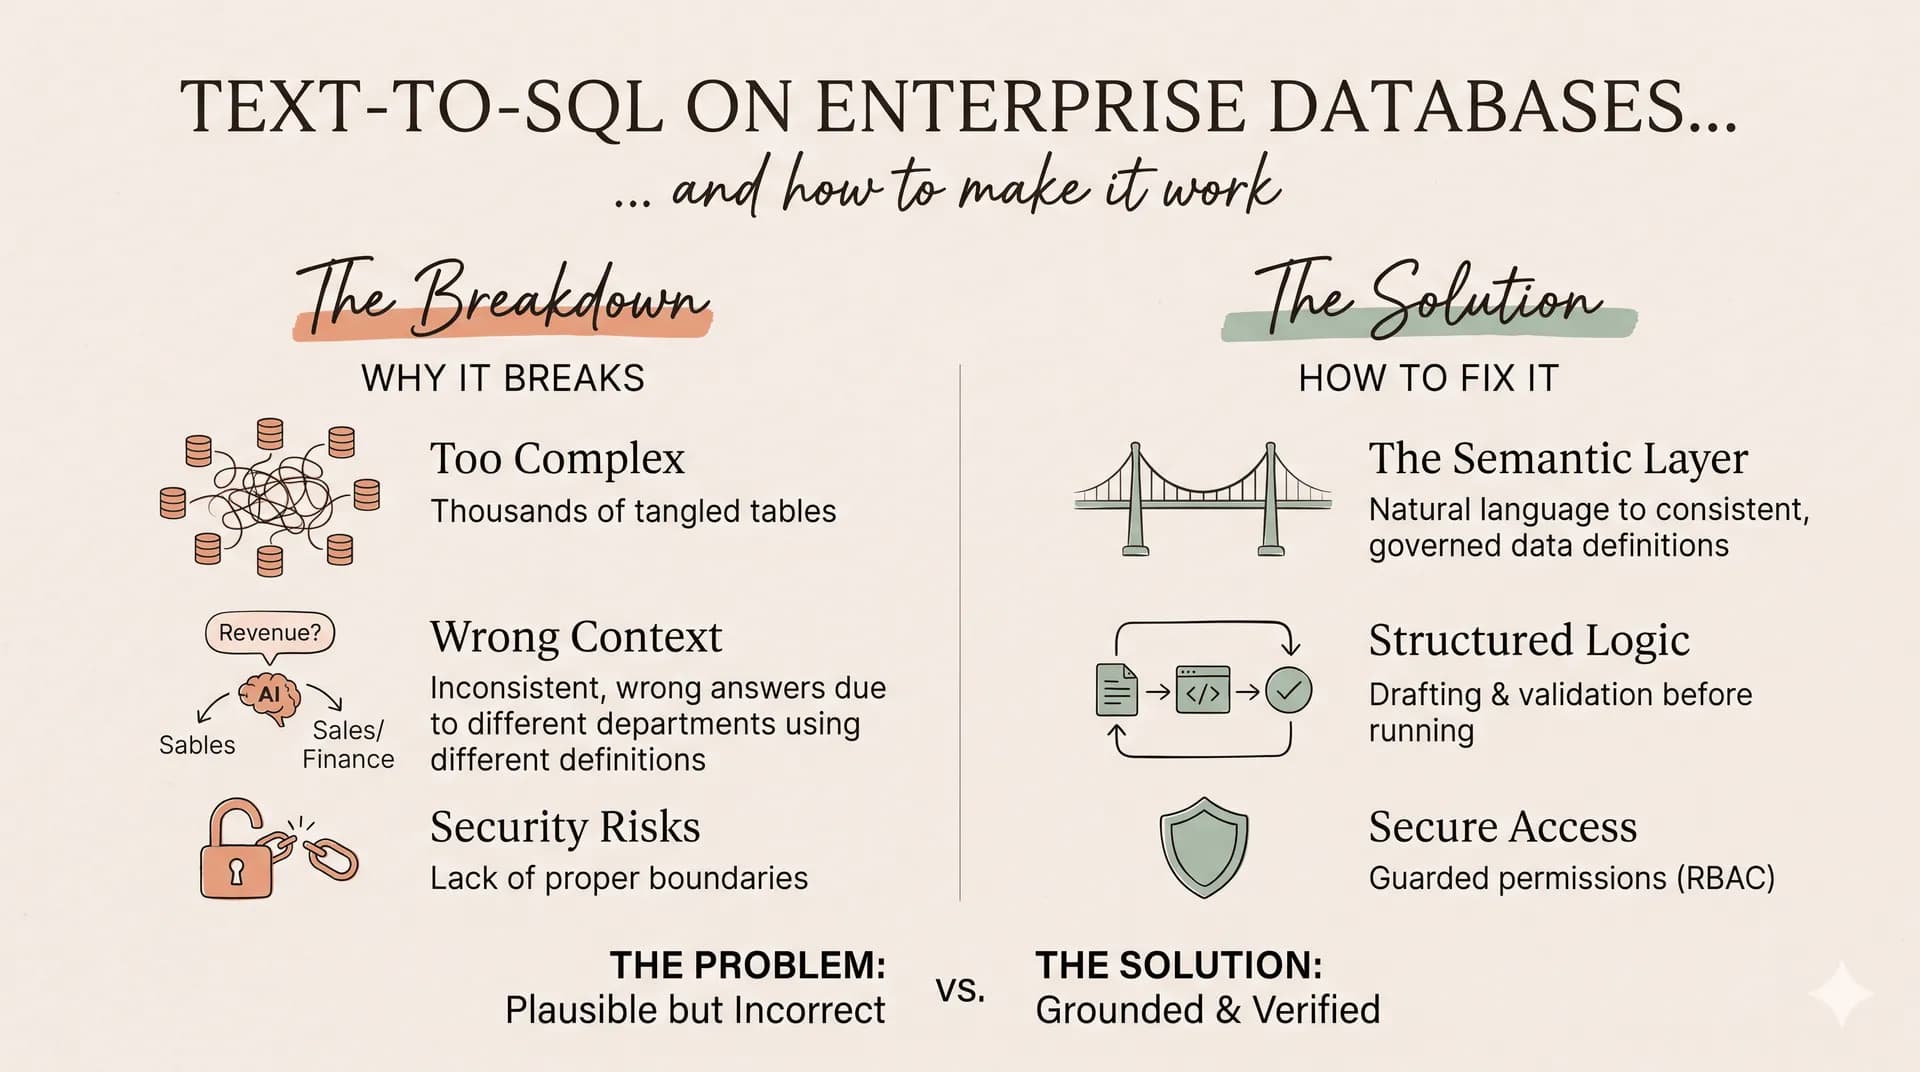
يعد هذا أحد أكبر التحديات في بناء أنظمة موثوقة لتحويل النصوص إلى استعلامات (Text-to-SQL) على مستوى المؤسسات.
المشكلة لا تكمن ببساطة في عجز النماذج اللغوية الكبيرة عن كتابة كود SQL، بل تكمن في أن قواعد بيانات المؤسسات تحتوي على تعقيدات تفوق قدرة أي نموذج على استيعابها بصورة موثوقة من خلال موجه أو أمر نصي واحد.
إن تقنية Text-to-SQL المؤسسية الموثوقة تتطلب أكثر من مجرد توليد استعلامات SQL؛ إنها تتطلب سياق قاعدة البيانات الصحيح، وتعريفات أعمال دقيقة، وعلاقات ربط صالحة، وآلية للتحقق من الاستعلام قبل تنفيذه.
فخ قواعد البيانات التجريبية
تعتمد معظم العروض التوضيحية لتقنيات Text-to-SQL على قواعد بيانات صغيرة ونظيفة نسبياً.
يتضمن المثال النموذجي جداول واضحة مثل:
- customers (العملاء)
- orders (الطلبات)
- products (المنتجات)
- payments (المدفوعات)
في هذه النماذج تكون العلاقات واضحة وبسيطة، وأسماء الجداول وصفية ومعبرة، والأعمدة مألوفة، ومنطق الأعمال شديد الوضوح.
لكن قواعد بيانات المؤسسات الفعلية تختلف جذرياً.
الأنظمة المبنية على منصات مثل Oracle E-Business Suite أو SAP أو غيرها من أنظمة ERP الضخمة قد تحتوي على آلاف الجداول ونماذج بيانات بالغة التعقيد.
تأمل مثلاً أسماء جداول مثل:
- MTL_SYSTEM_ITEMS_B
- RA_CUSTOMER_TRX_ALL
- AP_INVOICES_ALL
قد تكون هذه المسميات مألوفة لمختص أنظمة ERP، لكنها غامضة ومبهمة بالنسبة لنموذج لغوي للأغراض العامة.
وحتى عندما ينجح النموذج في تحديد الجدول المناسب، يظل بحاجة إلى فهم:
- ما هي الأعمدة التي تحتوي بالفعل على البيانات المطلوبة؟
- كيف يرتبط هذا الجدول بالكيانات والمفاهيم الأخرى في المنشأة؟
- ما هي مسارات الربط الصالحة للإجابة عن هذا السؤال تحديداً؟
- هل تمثل هذه البيانات معاملات فعلية، أم أرصدة، أم ملخصات دورية؟
- ما هي القواعد المحاسبية المعتمدة التي تحدد النتيجة النهائية؟
في أنظمة المؤسسات، تعتمد الإجابة الصحيحة دائماً على معارف لا تظهر مباشرة في أسماء الجداول أو الأعمدة، وهنا يبدأ النهج التقليدي للذكاء الاصطناعي في الانهيار.
ثلاثة أسباب وراء فشل أنظمة Text-to-SQL في المؤسسات
1. إرهاق نافذة السياق بالمخططات الضخمة
تستطيع النماذج اللغوية الكبيرة معالجة قدر محدود من السياق في المرة الواحدة.
إن تزويد النموذج بالمخطط الكامل لقاعدة بيانات مؤسسية ضخمة إما أن يتجاوز سعة نافذة السياق المتاحة، أو يستهلك قسطاً هائلاً منها بحيث يصبح من الصعب استغلال المعلومات المهمة بفاعلية.
وحتى لو اتسع السياق تقنياً للمخطط، فإن حشو آلاف الجداول غير ذات الصلة يولد ضوضاء هائلة.
تخيل أن تطلب من النموذج حساب إيرادات العملاء بينما تمده ببيانات وصفية تخص المخزون، والرواتب، والمشتريات، والتصنيع، والشحن، والقوائم المالية؛ عندها سيصعب على النموذج التمييز بين الجداول المعنية وغيرها.
يؤدي ذلك إلى اختيار جداول غير صحيحة، وإغفال أعمدة أساسية، وتوليد استعلامات مبنية على سياق ناقص.
الحل هنا لا يكمن في ضخ مزيد من بيانات المخطط للنموذج، بل في تصفية واستخراج ما يهم فقط قبل مطالبته بكتابة الاستعلام.
2. عمليات الربط الخاطئة وتوهم استعلامات SQL تبدو صحيحة
تحتوي قواعد بيانات المؤسسات في كثير من الأحيان على جداول متعددة تبدو جميعها مرتبطة بالسؤال نفسه.
قد تجد العميل ممثلاً في جدول رئيسي، وجدول فواتير، وجدول مدفوعات، وجدول تقارير دورية. يجب على النموذج ألا يكتفي باختيار الجداول الصحيحة فقط، بل أن يدرك العلاقات السليمة التي تجمع بينها.
وبدون بيانات دقيقة حول هذه العلاقات، قد يقوم النموذج بربط الجداول استناداً إلى تطابق أسماء الأعمدة أو افتراضات غير دقيقة اكتسبها أثناء التدريب.
النتيجة هي كود SQL يبدو سليماً برمجياً ويعمل دون أن يُصدر أي خطأ، لكنه يقدم أرقاماً غير صحيحة إطلاقاً.
على سبيل المثال، ربط ترويسة الفاتورة بسطورها ثم ربط المدفوعات دون مراعاة شروط العلاقات يمكن أن يضاعف مبالغ المعاملات بصورة متكررة، ما يعطي أرقام إيرادات متضخمة أو ترتيباً خاطئاً للعملاء.
الخطأ الأكثر خطورة في استعلامات SQL ليس الكود الذي يتوقف عن العمل، بل الكود الذي ينفذ بنجاح تام ويعود بنتائج خاطئة.
3. غياب تعريفات الأعمال ومنطق المحاسبة
نادراً ما تتطابق مصطلحات قواعد البيانات مع مصطلحات العمل اليومية في الشركات.
تأمل هذا السؤال: "ما هي إيراداتنا في الربع الأخير؟"
بحسب طبيعة كل مؤسسة، قد تعني "الإيرادات":
- إجمالي المبالغ المفصلة في الفواتير الصادرة.
- الإيراد الصافي بعد احتساب الخصومات والمرتجعات.
- الإيرادات المعترف بها محاسبياً وفق المعايير المالية.
- الإيرادات غير شاملة الضرائب والرسوم.
- الإيرادات المحصلة من المعاملات المكتملة فقط.
وبالمثل، فإن مصطلح "العميل النشط" قد يعني عميلاً أجرى عملية شراء خلال آخر 90 يوماً، أو عميلاً يمتلك عقداً سارياً، أو حساباً لم يتم إلغاء تنشيطه يدوياً.
لا يمكن لأي نموذج استنتاج هذه التعريفات تلقائياً من مجرد قراءة أسماء الأعمدة. وبدون الوصول المباشر لقواعد عمل المؤسسة، سيولد استعلاماً صحيحاً برمجياً لكنه يجيب عن سؤال آخر تماماً.
لهذا السبب تحتاج المؤسسات إلى "طبقة دلالية للأعمال" (Semantic Layer) تربط لغة الأعمال ببنية قاعدة البيانات.
كيف ترفع دقة تقنية Text-to-SQL في قواعد بيانات المؤسسات؟
لا ينبغي للنظام المعتمد أن يرسل مخطط قاعدة البيانات بالكامل إلى النموذج مع كل سؤال يطرحه المستخدم.
بدلاً من ذلك، يجب أن يسترجع سياق قاعدة البيانات المعني بالسؤال فقط، ويحدد العلاقات الصالحة، ويطبق تعريفات الأعمال المعتمدة، ثم يولد استعلام SQL ويتحقق من صحته.
الخطوة 1: بناء دليل موحد لمخطط قاعدة البيانات (Schema Catalog)
ابدأ بجمع البيانات الوصفية من قاعدة البيانات، على أن يتضمن هذا الفهرس:
- أسماء الجداول والواجهات (Views).
- أسماء الأعمدة وأنواع البيانات.
- المفاتيح الأساسية والخارجية (Primary & Foreign Keys).
- القيود والفهارس المطبقة.
- شروح وأوصاف الجداول والأعمدة.
- العلاقات المعروفة وواجهات التقارير السابقة.
تتحول هذه البيانات الوصفية إلى الركيزة الأساسية لفهم بنية البيانات. وبدلاً من فحص قاعدة البيانات التشغيلية عند كل استعلام، يحتفظ النظام بفهرس قابل للبحث والتحديث كلما طرأت تعديلات على البنية.
في أنظمة المؤسسات، قد يتطلب الفهرس أيضاً توثيق العلاقات على مستوى التطبيق التي لا تفرضها قيود قاعدة البيانات الصريحة.
الخطوة 2: استخدام استرجاع المخطط والربط الدلالي (Schema Linking)
عندما يطرح المستخدم سؤالاً، يتولى النظام تحديد الجداول والأعمدة المرتبطة مباشرة بالطلب عبر ما يُعرف بعملية استرجاع المخطط والربط الدلالي.
فعلى سبيل المثال، السؤال التالي: "من هم أفضل 10 عملاء لدينا من حيث الإيرادات في الربع الأخير؟" قد يتطلب الوصول إلى:
- العملاء
- الفواتير
- سطور بنود الفواتير
- الإشعارات الدائنة أو المرتجعات
- القواعد المحاسبية المحددة للإيرادات
- تواريخ المعاملات
يساعد الاسترجاع الدلالي في العثور على الجداول المطلوبة وفق شروحها ومعانيها وعلاقتها بالسؤال، ثم تقوم آلية الربط الدلالي بمطابقة المفاهيم المذكورة في نص السؤال مع عناصر قاعدة البيانات بدقة.
وبدلاً من كشف آلاف الجداول أمام النموذج، يحصل النموذج على مجموعة مركزة ومحدودة من البيانات الوصفية، ما يحد من التشتت ويساعده على اتخاذ قرارات صائبة.
الخطوة 3: توظيف الشبكة البيانية للمخطط لتحديد مسارات الربط الصحيحة
العثور على الجداول المناسبة ليس سوى نصف الحل؛ إذ يجب على النظام فهم آلية الترابط بينها.
تمثل الشبكة البيانية للمخطط الجداول على هيئة عقد (Nodes) وعلاقات الربط بينها على هيئة خطوط اتصال (Edges)، مثل:
العملاء ← الفواتير ← سطور الفواتير
تساعد هذه الشبكة في تحديد المسارات الصالحة بين الجداول اللازمة لحل السؤال. وعندما يتطلب الاستعلام ربط بيانات العميل بإيرادات المعاملات، يسترجع النظام العلاقات الصحيحة بدلاً من ترك النموذج يخمن شروط الربط.
علاوة على ذلك، فإن قيود المفاتيح الخارجية وحدها قد لا تكون كافية دائماً، نظراً لوجود قيود مفقودة أو علاقات محددة برمجياً داخل التطبيقات؛ لذا ينبغي أن تدمج الشبكة البيانية الموثوقة بين البيانات الوصفية لقاعدة البيانات والعلاقات الموثقة للأعمال.
الخطوة 4: إضافة طبقة دلالية لمنطق الأعمال (Business Semantic Layer)
تربط الطبقة الدلالية بين المصطلحات التي يستخدمها فريق العمل وهياكل الجداول وحساباتها الرقمية، حيث تحدد مقاييس مثل:
- الإيرادات
- إجمالي الهامش الربحي
- العملاء النشطين
- الإيرادات الشهرية المتكررة (MRR)
- القيمة الدائمة للعميل (LTV)
يحدد كل تعريف كيفية حساب المقياس، والجداول والأعمدة المعنية، والاستثناءات أو التصفية الواجب تطبيقها.
وعندما يسأل المستخدم عن مؤشر معين، يستحضر النظام تعريفه المعتمد مع سياق قاعدة البيانات، ما يحول دون قيام النموذج بابتكار منطق عشوائي من تلقاء نفسه، ويضمن اتساق التحليلات ومطابقتها عبر مختلف الفرق والأقسام.
الخطوة 5: توليد استعلام SQL والتحقق من صحته قبل التنفيذ
بمجرد توفر المخطط المناسب والعلاقات وتعريفات الأعمال، يقوم النموذج اللغوي بتوليد استعلام SQL، لكن التوليد لا يمثل المحطة الأخيرة.
يجب على النظام فحص الاستعلام مسبقاً والتأكد من عدة نقاط أساسية:
- هل الجداول والأعمدة المذكورة موجودة وصحيحة؟
- هل بنيت عمليات الربط على علاقات حقيقية وصالحة؟
- هل يلتزم الاستعلام بالتعريف المعتمد لحساب المقياس؟
- هل الاستعلام مقتصر على القراءة فقط ومصرح بتشغيله؟
- هل يحتوي على محددات وشروط تصفية ملائمة تحمي الأداء؟
- هل قد تتسبب شروط الربط في تكرار السجلات وتضخيم القيم المجمعة؟
كما ينبغي ضبط صلاحيات الوصول لقاعدة البيانات، وتحديد مهل زمنية للاستعلامات، وتعيين حدود لاستهلاك الموارد تجنباً لأي عمليات مكلفة أو غير مقصودة. فالهدف ليس تشغيل كود SQL فقط، بل ضمان تقديم إجابة صحيحة وآمنة تعبر عن السؤال المطروح.
مثال عملي: من السؤال الطبيعي إلى استعلام SQL
لنعد إلى السؤال: "من هم أفضل 10 عملاء لدينا من حيث الإيرادات في الربع الأخير؟"
المسار الهندسي الموثوق لمعالجة هذا الاستعلام يمر عبر ست خطوات:
1. فهم السؤال: تحديد المقياس المطلوب، والإطار الزمني، وآلية الترتيب، والكيان المعني.
2. استرجاع البيانات الوصفية: تحديد جداول العملاء، والفواتير، والمعاملات، وأعمدتها المرتبطة.
3. تطبيق تعريف الأعمال: جلب المعادلة المعتمدة لحساب الإيرادات وكيفية التعامل مع الضرائب والمرتجعات.
4. تحديد مسار الربط المعتمد: استخدام الشبكة البيانية للربط بين سجلات العملاء ومعاملات الإيراد الصحيحة.
5. توليد الاستعلام وفحصه: كتابة الكود والتحقق من هيكله، وروابطه، وشروط التصفية، والصلاحيات الأمنية.
6. التنفيذ واستعراض النتيجة: تشغيل الاستعلام بأمان وتقديم الإجابة مع توضيح التعريف المستخدم وسياق الحساب.
الفرق الجوهري هنا هو أن النموذج لا يبدأ من الصفر محاولاً اكتشاف بنية قاعدة البيانات وقواعدها في كل مرة، بل يحصل على سياق مدروس يجيب عن السؤال بدقة.
أثر ذلك على قرارات الشركات المعتمدة على الذكاء الاصطناعي
التحديات التقنية في تحويل النصوص إلى استعلامات لها انعكاسات مباشرة على العمل؛ فربط خاطئ للجداول قد يرفع أرقام الإيرادات بصورة وهمية، وتضارب تعريفات المؤشرات قد يدفع الفرق المالية وفرق المبيعات لتقديم بيانات متعارضة للإدارة.
المسألة لدى الشركات لا تقتصر على مجرد السؤال: "هل يستطيع الذكاء الاصطناعي كتابة كود SQL؟" بل: "هل يمكن لهذا النظام تقديم إجابات دقيقة وموثوقة بصورة مستمرة بالاعتماد على بياناتنا الحقيقية؟"
كيف تساهم منصة Zero Queries في منظومة Text-to-SQL المؤسسية؟
تركز Zero Queries على تمكين الوصول إلى البيانات بسهولة عبر واجهة تفاعلية تعتمد على اللغة الطبيعية دون التفريط في الدقة.
الجاهزية للعمل في بيئة المؤسسات تتطلب أكثر من مجرد شاشة محادثة؛ فالنظام الداعم يجب أن يتعامل باحترافية مع بنية الجداول، ومصطلحات الأعمال، ومسارات الربط، وضوابط الأمان.
عند تقييم الحلول لمنشأتك، اطرح الأسئلة العملية التالية:
- هل يتوافق الحل مع قواعد البيانات والبنى التحتية التي تعتمدها شركتك؟
- كيف يفهم النظام المخططات الضخمة لقواعد بياناتك؟
- كيف يعالج الأسئلة المعقدة التي تشترك فيها جداول متعددة؟
- كيف يضمن دقة وصحة التعريفات واستعلامات SQL المولدة؟
- كيف يندمج بسلاسة ضمن بيئة وسير عمل التحليلات الحالية لديك؟
الطريقة الأمثل لاختبار أي منصة تحليلات بالذكاء الاصطناعي هي قياس أدائها أمام أسئلة العمل الواقعية، وليس مجرد تجربتها على قواعد بيانات تجريبية مبسطة.
معايير تقييم حلول Text-to-SQL للمؤسسات
عند دراسة منصات التحليلات المعتمدة على الذكاء الاصطناعي، يجب التركيز على المحاور التالية:
استيعاب المخططات المعقدة
- ما هو أضخم مخطط تم اختبار النظام عليه بنجاح في بيئة فعلية؟
- كيف يحدد النظام الجداول والأعمدة المطلوبة بدقة؟
- هل يدعم أنظمة ERP الكبرى مثل SAP وOracle؟
استكشاف العلاقات ومسارات الربط
- كيف يتعرف النظام على روابط الجداول الصالحة؟
- هل يعتمد على المفاتيح الخارجية فقط، أم يدعم العلاقات المعرفة برمجياً في التطبيقات؟
إدارة تعريفات الأعمال
- أين تُحفظ معادلات المؤشرات وقواعد العمل؟
- من يتولى اعتماد وتعديل تلك القواعد في المؤسسة؟
- كيف يتعامل النظام مع المصطلحات الإدارية المتشابهة أو الغامضة؟
فحص الاستعلامات والأمان
- كيف يتم فحص استعلامات SQL والتحقق منها قبل تنفيذها؟
- هل يدعم النظام صلاحيات القراءة فقط وفرض مهل وحدود للأداء؟
- كيف يمنع الربط المتوهم والاستعلامات غير الآمنة؟
التقييم والمراقبة المستمرة
- كيف تُقاس دقة الإجابات في ظل الأسئلة اليومية المعقدة؟
- هل يمكن للفرق التقنية تتبع خطوات ومبررات الاستعلام المولد بدقة؟
الأسئلة الشائعة
ما هي تقنية Enterprise Text-to-SQL؟
هي تقنية تحول أسئلة الأعمال المكتوبة باللغة الطبيعية إلى استعلامات SQL ضد قواعد بيانات المؤسسات الضخمة، وتتطلب سياقاً دقيقاً لقاعدة البيانات وتعريفات أعمال واضحة وآليات تحقق لضمان الموثوقية.
لماذا تواجه هذه التقنية صعوبة مع قواعد البيانات الضخمة؟
نظراً لكثرة الجداول وتشابك العلاقات، واختلاف تسميات الأعمدة، ووجود قواعد محاسبية غير مسجلة صراحة في المخطط، ما يؤدي إلى تشتيت النموذج اللغوي وزيادة معدلات الخطأ.
كيف يمكن تحسين دقة استعلامات Text-to-SQL؟
من خلال استرجاع المخطط الانتقائي، والربط الدلالي، والشبكات البيانية لمسارات الربط، وبناء طبقة دلالية لمنطق الأعمال، وفحص الاستعلامات برمجياً قبل تشغيلها.
ما هو الربط الدلالي (Schema Linking)؟
هو عملية ربط الكلمات والمفاهيم الواردة في سؤال المستخدم بالعناصر المقابلة لها في قاعدة البيانات (مثل الجداول، والأعمدة، والمفاتيح).
هل يمكن للذكاء الاصطناعي الاستعلام من قواعد بيانات SAP وOracle باللغة الطبيعية؟
نعم، شريطة استخدام نظام يفهم نماذج بيانات ERP المعقدة، ويسترجع العلاقات الصحيحة، ويطبق منطق الأعمال الخاص بالمؤسسة قبل تنفيذ الاستعلام.
الخلاصة: Text-to-SQL المؤسسي يتطلب ما هو أكثر من مجرد نموذج لغوي
إن تحدي تحويل النصوص إلى استعلامات في بيئة المؤسسات لا يقتصر على ترجمة الكلمات إلى كود SQL، بل يتمثل في فهم قاعدة البيانات المعقدة، واستخراج المعلومات السليمة، وتطبيق منطق الأعمال بدقة، وتوليد استعلامات تحظى بالثقة الكاملة.
المستقبل لا يقاس بسرعة كتابة الكود، بل بمدى صحة النتائج واتساقها لدعم اتخاذ القرار بثقة.